ペンテストとコードレビューの検証結果

はじめに
AWS Security Agent のペネトレーションテスト(以下、ペンテスト)を、意図的に脆弱性を仕込んだ自作の Flask アプリ(以下、対象アプリ)に対して、インターネット公開 + AWS WAF(以下、WAF)の構成で 3 回実行した。続けて、同じアプリのソースコードに対してコードセキュリティレビュー(以下、コードレビュー)を実行した。本記事は、その実行で何が起きたかの記録である。
本記事は結果と解釈だけを扱う。仕組みと用語は ペンテストの仕組みと設計、再現の手順は ペンテストの手順 と GitHub 連携とコードレビューの手順(後日公開) にある。
対象読者は、AWS での構築経験があり(VPC、ALB、IAM、Terraform を扱える程度)、脆弱性診断には詳しくない人を想定している。検出結果の解釈は、Security Agent が出力したレポートと実行ログの記述を根拠にしている。筆者は脆弱性診断を専門にしていないため、解釈に誤りがあればご容赦いただきたい。
検証環境の要約

- 対象アプリは Flask + SQLite の小さな Web アプリで、応答する URL のパスは 8 つ。EC2(t3.micro、パブリック IP なし)で動き、ALB(HTTPS のみ)の背後に置いた
- ALB には WAF の Web ACL を関連付けた。既定動作(どのルールにも一致しなかったリクエストに適用する動作)は遮断で、Security Agent が付けるカスタムヘッダー(
X-Pentest-Token)の値が一致したリクエストだけを通すルール(以下、ヘッダー許可ルール)と、AWS マネージドルール 5 つ(Common、KnownBadInputs、SQLi、Linux、AdminProtection。以下、マネージドルール群)を置いた - ヘッダー許可ルールを先に評価する構成を agent-first、マネージドルール群を先に評価する構成を managed-first と呼ぶ。agent-first ではエージェントの通信は WAF の検査を受けずにアプリへ届き、managed-first では攻撃パターンに一致した通信が WAF で止まる
- 対象アプリのホスト名は
pentest.lab.infra.jpで、検証で使った実際の名前をそのまま書いている。検証環境は削除済みで、この URL には到達できない
対象アプリに仕込んだ 7 件の脆弱性
| ID | 種類 | どこに | できてしまうこと |
|---|---|---|---|
| PLANTED-1 | SQL インジェクション | 検索(/search) | 検索語がそのままデータベースへの命令文に混ざる。本来見えないデータ(他の利用者の情報)を取り出せる |
| PLANTED-2 | IDOR(安全でない直接オブジェクト参照) | プロフィール(/profile) | URL の番号を変えるだけで他人のプロフィールが見える。ログインも本人確認もしていない |
| PLANTED-3 | マスアサインメントによる権限昇格 | 登録(/register) | 登録フォームで送る項目に役割(role)を足すと、そのまま保存される。自分を管理者として登録できる |
| PLANTED-4 | パストラバーサル | ファイル取得(/download) | ファイル名の指定に .. や絶対パスを使うと、公開するつもりのないファイル(アプリのソースなど)まで読める |
| PLANTED-5 | 格納型 XSS | コメント(/comment) | 投稿した文章に仕込んだスクリプトがそのまま保存・表示され、ほかの閲覧者のブラウザで実行される(XSS はクロスサイトスクリプティング。保存されて後で表示されるものを格納型、その場の応答に返るものを反射型と呼ぶ) |
| PLANTED-6 | 認証なしの機密情報露出 | 設定 API(/api/config) | ログインしなくても設定値(鍵など。値はすべてダミー)を返す |
| PLANTED-7 | 推測可能なセッション | ログイン(/login)、管理画面(/admin) | ログイン状態を示す Cookie が署名のない番号なので、番号を書き換えるだけで他人(管理者)になりすませる。管理者になると管理画面で全利用者の平文パスワードが見える |
この 7 件の一覧(PLANTED の番号と内容)は当初、対象アプリのソース(app/app.py)の冒頭にコメントで書いていた。agent-first の 2 回の実行でエージェントがそのソースを読めることが分かり、managed-first の前にソースから外して別ファイルへ移した。この経緯は「検出能力」の節で述べる。
3 回のペンテストと 1 回のコードレビュー
| 実行 | 検証日と時刻(JST) | WAF の評価順 | 終わり方 |
|---|---|---|---|
| agent-first(手動停止) | 1 日目 00:00〜00:49 | ヘッダー許可ルールが先 | 開始から約 48 分、約 3 Task-hour の時点で手動停止 |
| agent-first(完走) | 1 日目 21:14〜23:06 | ヘッダー許可ルールが先 | 全段階が完了 |
| managed-first | 2 日目 23:10〜翌 03:08 | マネージドルール群が先 | 全段階が完了 |
| コードレビュー(完走) | 3 日目 16:26〜18:26 | (WAF を経由しない。GitHub 上のソースを読む) | 全段階が完了 |
コードレビューは、この完走の前にも 1 回実行し、途中で止めている。その実行の結果は本記事では扱わず、料金の記録(「所要時間と費用」の節)にだけ使う。
検証結果のサマリ
確かめたいことを 4 つに整理し、結果を先に示す。
| 確かめたいこと | 結果 |
|---|---|
| 公開方式での動作: WAF の既定動作を遮断にしたまま、ペンテストが最後まで通ること | 通った。ドメイン検証、プリフライト(実行前の到達性などの事前確認)、本番の検査のすべてが、既定動作を遮断にしたまま完了した。検査のリクエストには毎回カスタムヘッダーが付いていた(agent-first(手動停止)で 4,370 件)。Terraform で Application から Pentest まで作れたが、最大タスク時間だけは Terraform で設定できない |
| 検出能力: 仕込んだ脆弱性 7 件のうち検出した件数と、誤検知の有無 | 検出結果に登録されたのは、agent-first(手動停止)で 5 件、agent-first(完走)で 6 件、managed-first で 3 件(候補を含めて 5 件)。最後まで出なかったのは認証なしの機密情報露出(PLANTED-6)だけである。成立しない種類の脆弱性を検出結果にすることはなかった。ただし agent-first の 2 回は、エージェントがソースのコメントにあった仕込んだ脆弱性の一覧を読める状態だったため、件数を「答えを読まずに見つけた件数」とは言い切れない。コードレビューは 7 件すべてを検出し、PLANTED-6 もソースから見つけた |
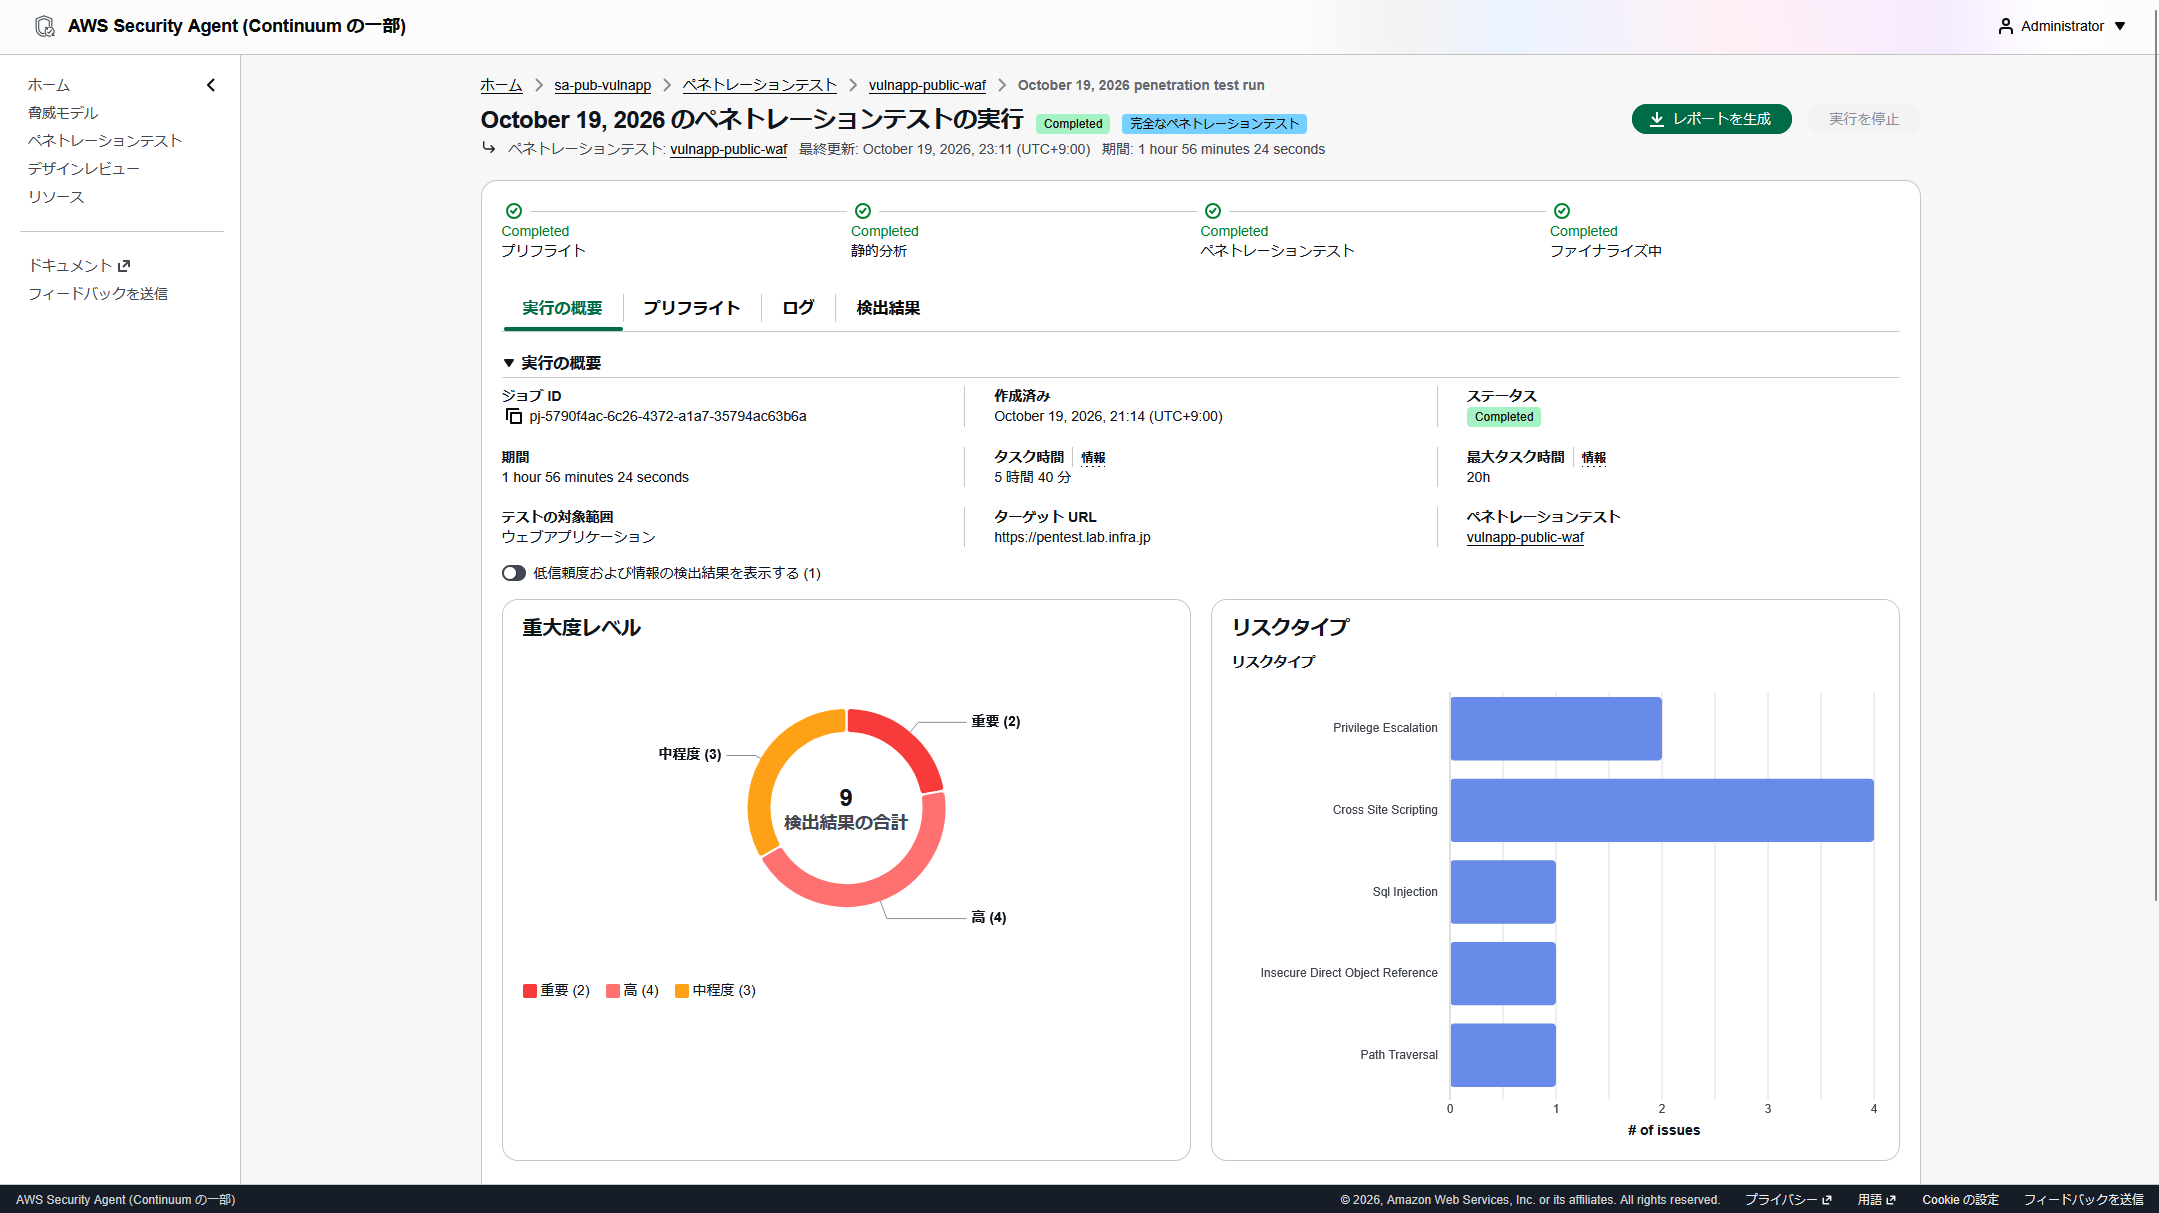
| WAF の防御: 第三者の遮断と、マネージドルール群が止める攻撃の範囲 | 第三者は届かなかった。agent-first(手動停止)の約 50 分の間に 12 の送信元から 22 件が来て、すべて WAF で遮断された。managed-first ではエージェントの通信 9,219 件のうち 3,215 件(約 35%)をマネージドルール群が止め、確定した検出結果は agent-first(完走)の 9 件(仕込んだ脆弱性 6 + それ以外 3)から 3 件(仕込んだ脆弱性のみ)に減った。ただし IDOR とパストラバーサルは WAF があっても同じ重大度で確定した |
| 所要時間と費用: Task-hour の消費と、無料トライアルの適用 | agent-first(手動停止)3 時間 6 分、agent-first(完走)5 時間 40 分、managed-first 12 時間 16 分。合計 21.02 Task-hour(定価換算 約 1,051 ドル)が、無料トライアルの適用で 0 ドルで計上された。コードレビューも別の使用タイプで 0 ドルだった。インフラ費用は検証期間 5 日間の合計で約 2.16 ドル |
留意点として、エージェントは 3 回とも、見つけたファイル読み取りの欠陥(PLANTED-4)を足がかりに対象アプリのソースコードを取得し、ほかの検査の手がかりにしていた。
公開方式での動作
ドメイン検証からプリフライトまで
公開方式では、テスト対象のドメインを自分が管理していることを先に確認する(ドメイン検証)。Security Agent に Target Domain を登録すると検証用の TXT レコードの名前と値が返り、それを DNS に置いてから検証(Verify)を実行する。この一連を Terraform と CLI でどう行ったかの仕組みは仕組みと設計の「Terraform で作れるリソース」と「apply が 2 回に分かれる理由」にある。この検証で観測した結果は次のとおり。
- Target Domain の登録と検証用 TXT レコードの作成は、1 回の apply で終わった。CLI で検証を実行すると即時に VERIFIED になった
- 手作業は、保有ドメインのレジストラで委任先のネームサーバーを登録する 1 回だけで、委任の反映には約 20 分かかった
- Pentest は、ドメインが VERIFIED になるまで作成を拒否された(API が InvalidRequest で「The domain of the endpoint hasn’t been verified」を返した)。Application と Agent Space は、ドメインが PENDING のままでも作成できた
- プリフライトの 3 つのチェック(Logging Infrastructure Setup、Endpoint Accessibility Validation、Setup Testing Environment)は、3 回とも 3〜7 分で合格した。この間の Task-hour は 0 だった
カスタムヘッダーの付与
この構成では、エージェントのリクエストにカスタムヘッダーが付いていなければ WAF の既定動作で遮断され、検査がアプリに届かない。そこで、エージェントの全リクエストにヘッダーが付いていたかを WAF ログで確かめた。WAF ログには 1 リクエストにつき、許可か遮断かの判定と、その判定を下したルール(終了したルール)が記録される。ヘッダー付きのリクエストはヘッダー許可ルールで許可され、ヘッダーのないリクエストは既定動作かマネージドルール群で遮断されるので、判定とルールの組み合わせごとに件数を数えれば、ヘッダーの有無が分かる。agent-first(手動停止)の実行の時間帯で集計した結果は次のとおり。
| 評価順 | 判定 | 判定したルール | 件数 |
|---|---|---|---|
| 1 | 許可 | ヘッダー許可ルール | 4,370 |
| 2 | 遮断 | マネージドルール群(Common ルールセット) | 5 |
| 3 | 遮断 | 既定動作(どのルールにも一致しなかった) | 23 |
許可された 4,370 件はすべてヘッダー許可ルールによるもので、送信元はエージェントの 1 つのアドレス帯(東京リージョンの AWS のアドレス)だった。対象アプリ側のアクセスログでも、エージェントの User-Agent(securityagent)で届いたリクエスト 4,367 件は、すべてカスタムヘッダー付きだった(WAF 側との差 3 件は、集計する時間帯の境目の違いと考えられる)。
遮断された 28 件(5 + 23)を送信元で分けると次のとおり。送信元はログの httpRequest.clientIp で見分けた。
| 送信元 | Common ルールセットで遮断 | 既定動作で遮断 | 計 |
|---|---|---|---|
| エージェント(許可された 4,370 件と同じアドレス帯) | 1 | 5 | 6 |
| 第三者(12 の送信元) | 4 | 18 | 22 |
| 計 | 5 | 23 | 28 |
第三者の 22 件は次の「WAF の防御」で扱う。エージェントの送信元から来た 6 件は、いずれもトップページ(/)への GET で、カスタムヘッダーが付いていなかった。ヘッダー許可ルールに一致しないので評価はマネージドルール群に進み、User-Agent ヘッダーのない 1 件が Common ルールセットで遮断され、残りの 5 件はどのルールにも一致せず既定動作で遮断された。Common ルールセットには、User-Agent ヘッダーのないリクエストを遮断する規則 NoUserAgent_HEADER が含まれている(AWS WAF のベースラインルールグループ)。これはこの検証の設定ではなく、ルールセットの仕様である。
6 件とも、遮断されて 403 が返っている。どのルールで遮断されたかは重要ではなく、どの段階で送られたかが重要である。
段階によって意味が違うのは、実行の 4 段階のうちプリフライトだけが「関門」だからである。プリフライトの到達性のチェックに失敗すると、実行はそこで止まり、Task-hour は消費されない。合格すると静的分析に進み、Task-hour の消費が始まる。静的分析以降には実行を止める関門はなく、遮断されたリクエストは「その攻撃は通らなかった」という検査の結果として扱われるだけで、実行は最後まで進む(managed-first では通信の約 35% が遮断されたまま完走した)。
6 件のうち 5 件は静的分析以降に送られたもので、ヘッダー付きの検査リクエストが並行して通っていたこともあり、実行の進み方には関係しなかった。残る 1 件はプリフライトの「Endpoint Accessibility Validation」(到達性の確認)の間に送られたもので、WAF に遮断されて 403 が返ったにもかかわらず、このチェックは合格した。プリフライトが見ているのは「対象から HTTP の応答が返るか」であり、403 も応答の 1 つとして数えられるためである。
この挙動には注意が要る。たとえば WAF のヘッダー許可ルールと Pentest のカスタムヘッダーで値が食い違っていると、エージェントのリクエストはすべて 403 で遮断されるが、プリフライトは合格し、実行はそのまま進む。検査はアプリに届かないまま Task-hour だけが消費される。この誤りはプリフライトでは検出できないので、実行を始める前に、ヘッダーなしの curl で 403、ヘッダーありの curl で 200 が返ることを確かめておく(ペンテストの手順の手順 4)。
Terraform で作れた範囲
何を Terraform で作れるかは仕組みと設計の「Terraform で作れる範囲と限界」にある。この検証で観測した結果は次のとおり。
- Application、Agent Space、Target Domain、検証用の TXT レコード、Pentest までを Terraform(awscc プロバイダ)で作れた。公式サンプルに注記のある Pentest 作成のタイムアウトは起きなかった
- 最大タスク時間は Terraform で設定できず、CLI の
update-pentest --max-task-hoursで設定した。6 時間を指定すると「Max task hours must be at least 20 hours」と拒否され、25 時間は受け付けられた。最小値 20 時間は画面の選択肢ではなく API の制約である
検出能力
仕込んだ脆弱性 7 件との対応
検出結果(Security Agent が確定した脆弱性 1 件ごとの記録)と仕込んだ脆弱性の対応は次のとおり。括弧内は重大度と CVSS v3.1 のスコアで、どちらも Security Agent が検出結果ごとに付ける。重大度は 重要 > 高 > 中程度 > 低 > 情報 の順、CVSS は欠陥の深刻さを 0〜10 で表す点数である。コードレビューは CVSS をまだ出さない(画面では「開発中」)。
| 仕込んだ脆弱性 | agent-first(手動停止) | agent-first(完走) | managed-first | コードレビュー |
|---|---|---|---|---|
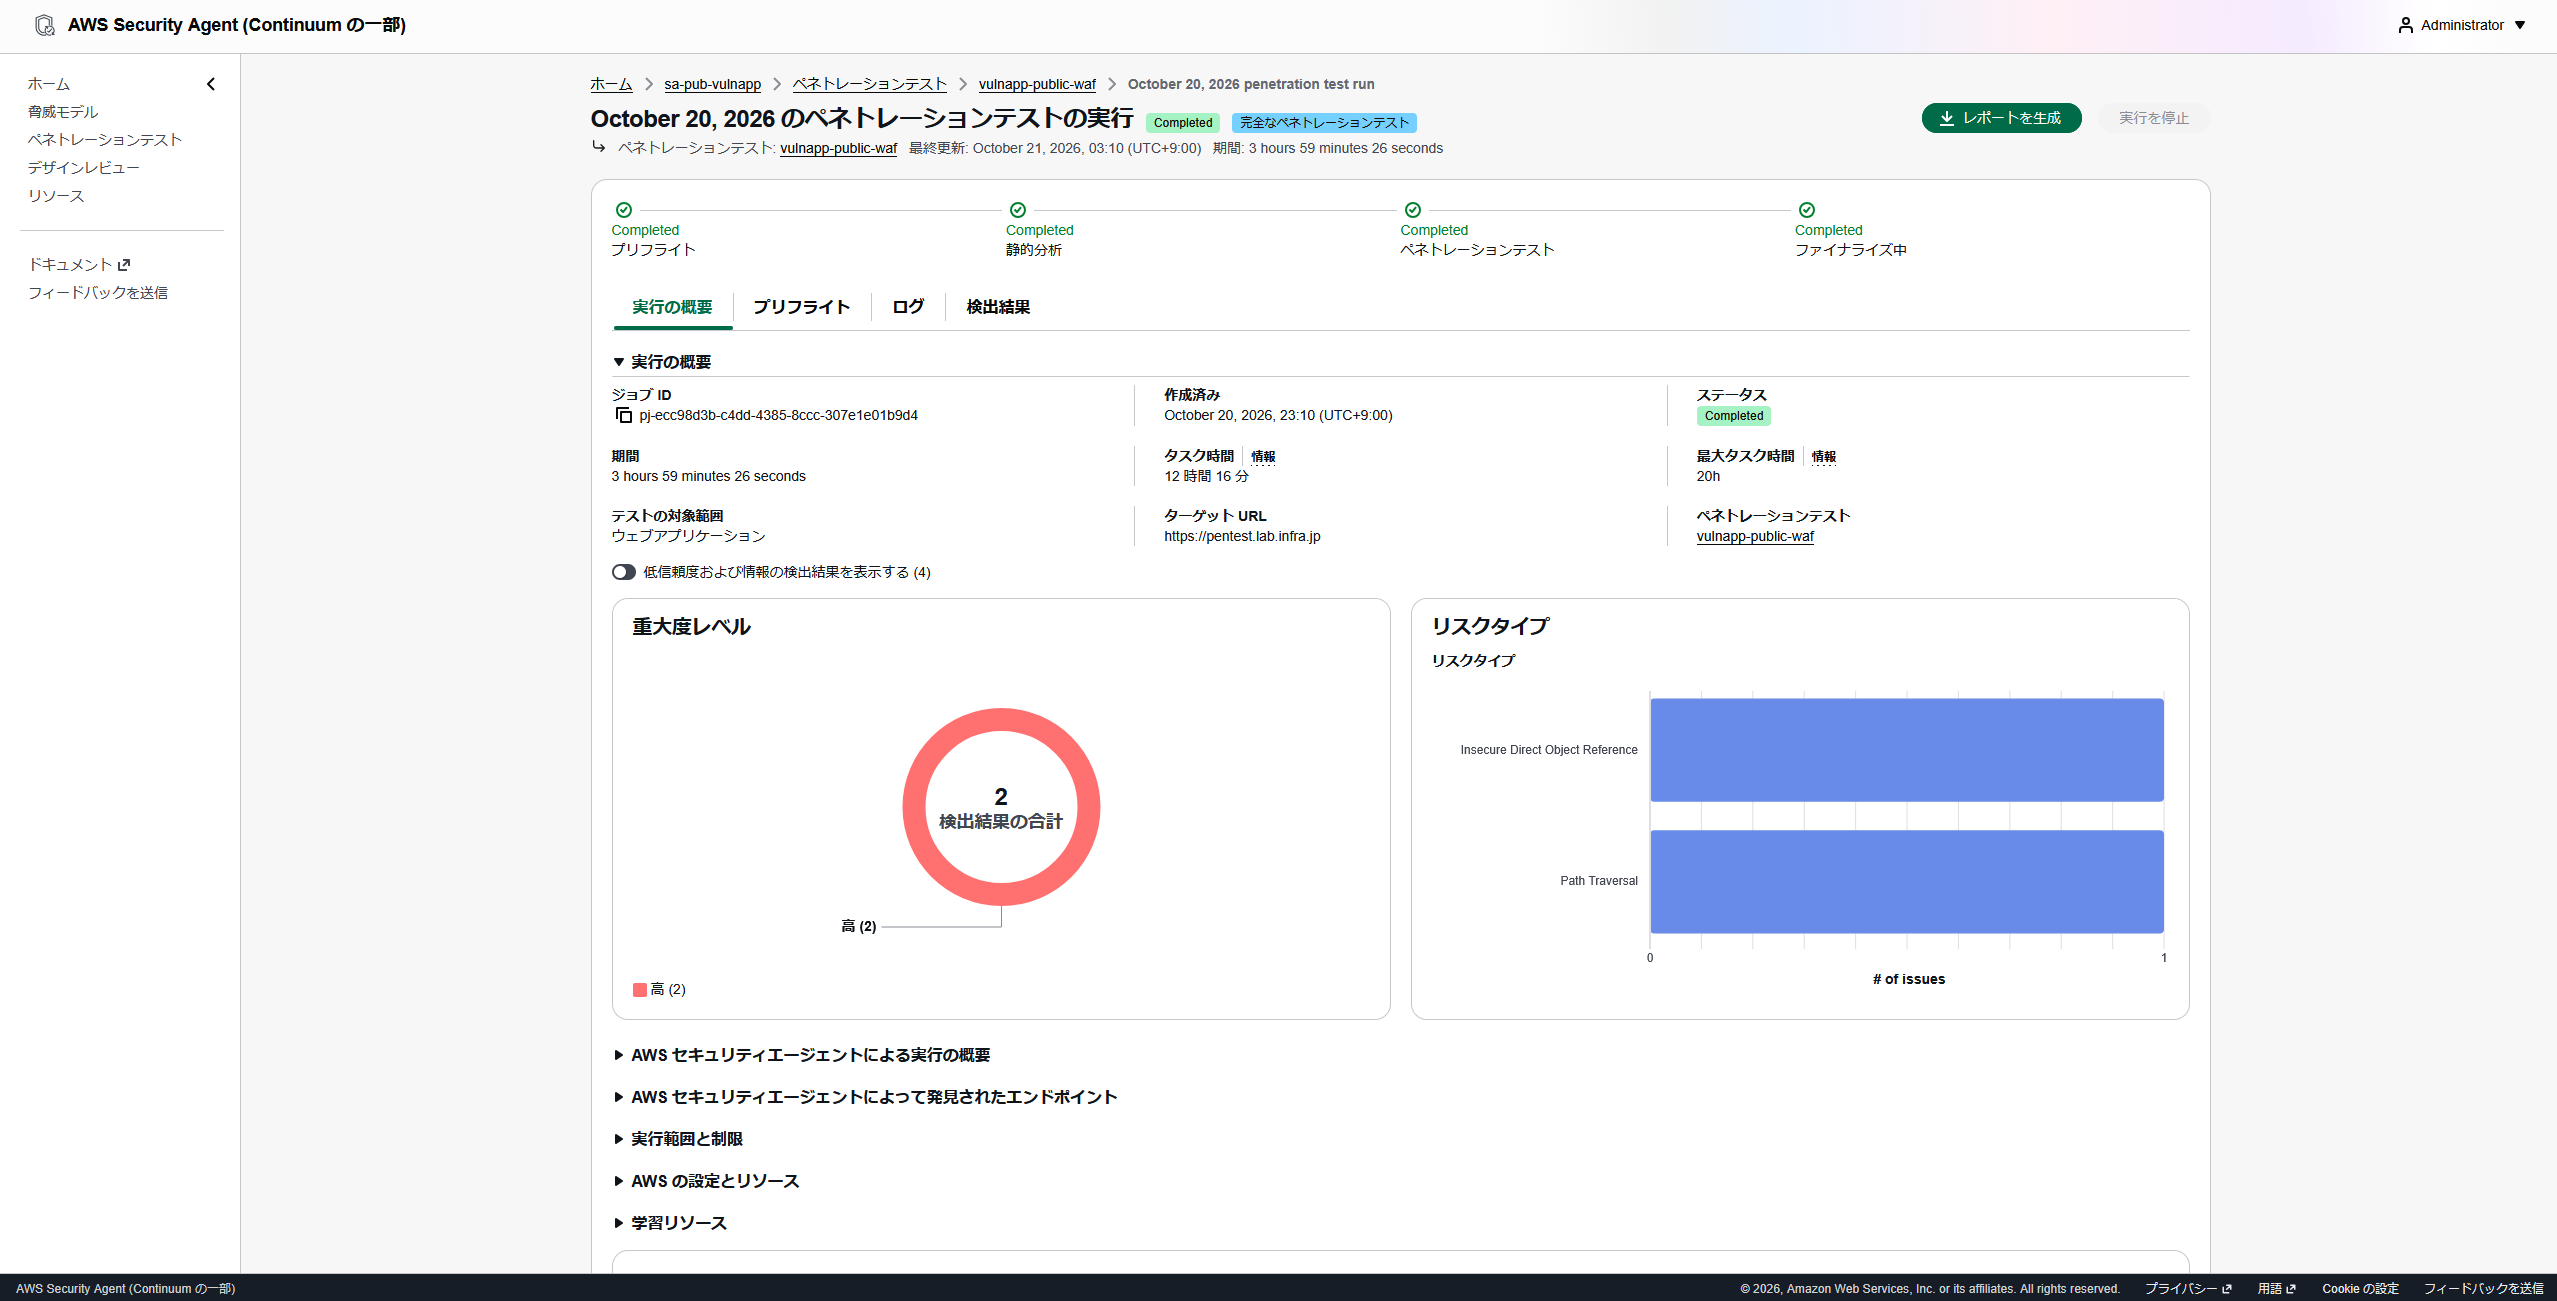
| PLANTED-1 SQL インジェクション | 検出(高、7.5) | 検出(高、7.5) | 検出(中程度、5.3) | 検出(高) |
| PLANTED-2 IDOR | 検出(高、7.5) | 検出(高、7.5) | 検出(高、7.5) | 検出(高) |
| PLANTED-3 マスアサインメント | 未検出 | 検出(重要、9.1) | 候補に挙がったが誤検知と判定 | 検出(高) |
| PLANTED-4 パストラバーサル | 検出(高、7.5) | 検出(高、7.5) | 検出(高、7.5) | 検出(高) |
| PLANTED-5 格納型 XSS | 検出(中程度、6.1) | 検出(中程度、6.1) | 候補に挙がったが未確認 | 検出(高) |
| PLANTED-6 機密情報露出 | 未検出 | 未検出 | 未検出 | 検出(高) |
| PLANTED-7 推測可能なセッション | 検出(重要、9.1) | 検出(重要、9.8) | 未検出 | 検出(重要) |
| 合計 | 7 件中 5 件 | 7 件中 6 件 | 7 件中 3 件(候補を含めて 5 件) | 7 件中 7 件 |
managed-first の列の「候補に挙がったが誤検知と判定」「候補に挙がったが未確認」は、次の流れで付く分類である。エージェントは、欠陥の疑いを見つけると検出結果の候補として登録し、検証タスクが実際に攻撃を試して再現を図る。再現できれば信頼度「高」の検出結果として確定する。再現できなかった場合、エージェントは理由を付けて分類を下げる。マスアサインメントは「管理者の役割は得られたが、管理画面への通信が WAF で止まるので、この配置では悪用できない」として誤検知に、XSS は「HTML は埋め込めるが、閲覧者のブラウザで実行されることを実証できない」として未確認に分類された。どちらも欠陥が存在しないという意味ではなく、この WAF の配置では実証に至らなかったという意味である。
検出結果の全体の件数は、仕込んだ脆弱性とそれ以外を合わせて、agent-first(手動停止)が 9 件(仕込んだ脆弱性 5 + それ以外 4)、agent-first(完走)が 10 件(仕込んだ脆弱性 6 + それ以外 4)、managed-first が 7 件(確定 3 + 候補 2 + それ以外 2)である。仕込んだ脆弱性以外の検出結果の内訳は次の節で述べる。
公式ドキュメントは、信頼度が高または中の検出結果だけを報告し、未検証のものは既定で隠すと説明している(Security Considerations)。画面の「実行の概要」の重大度のグラフは、既定では信頼度(エージェントが実証できた度合い。高・中・低・未確認・誤検知)の低いものと情報レベルのものを除いて数えるため、それぞれ 7 件、9 件、2 件と表示される。managed-first の確定 3 件のうち SQL インジェクションは信頼度が「中」のため、グラフには入らない。
仕込んでいない検出結果
仕込んだ脆弱性以外にも検出結果が出た。agent-first の 2 回ではそれぞれ 4 件で、内訳は XSS が 3 件と、HTTP のセキュリティヘッダーがないという指摘が 1 件である。XSS 3 件は、対象アプリが画面に出す文字をエスケープしない作りになっているために、コメント以外の場所にも生じたもので、意図して仕込んではいないが実在する欠陥である。場所は、検索のエラー表示と、登録した名前のプロフィールでの表示が 2 回に共通で、3 つ目は agent-first(手動停止)では登録フォームの role 欄、agent-first(完走)では管理画面の利用者一覧だった。レポートは再現手順付きで確認済みとしており、コードレビューも同じ箇所を指摘した。
managed-first では、XSS 3 件はどれも出なかった。セキュリティヘッダーの指摘は 3 回とも出た(managed-first では 2 件)が、扱いは回ごとに違った(agent-first(手動停止)では「情報」として確定、ほかの 2 回では「スキャン結果だけでは判断できない」として未確認)。
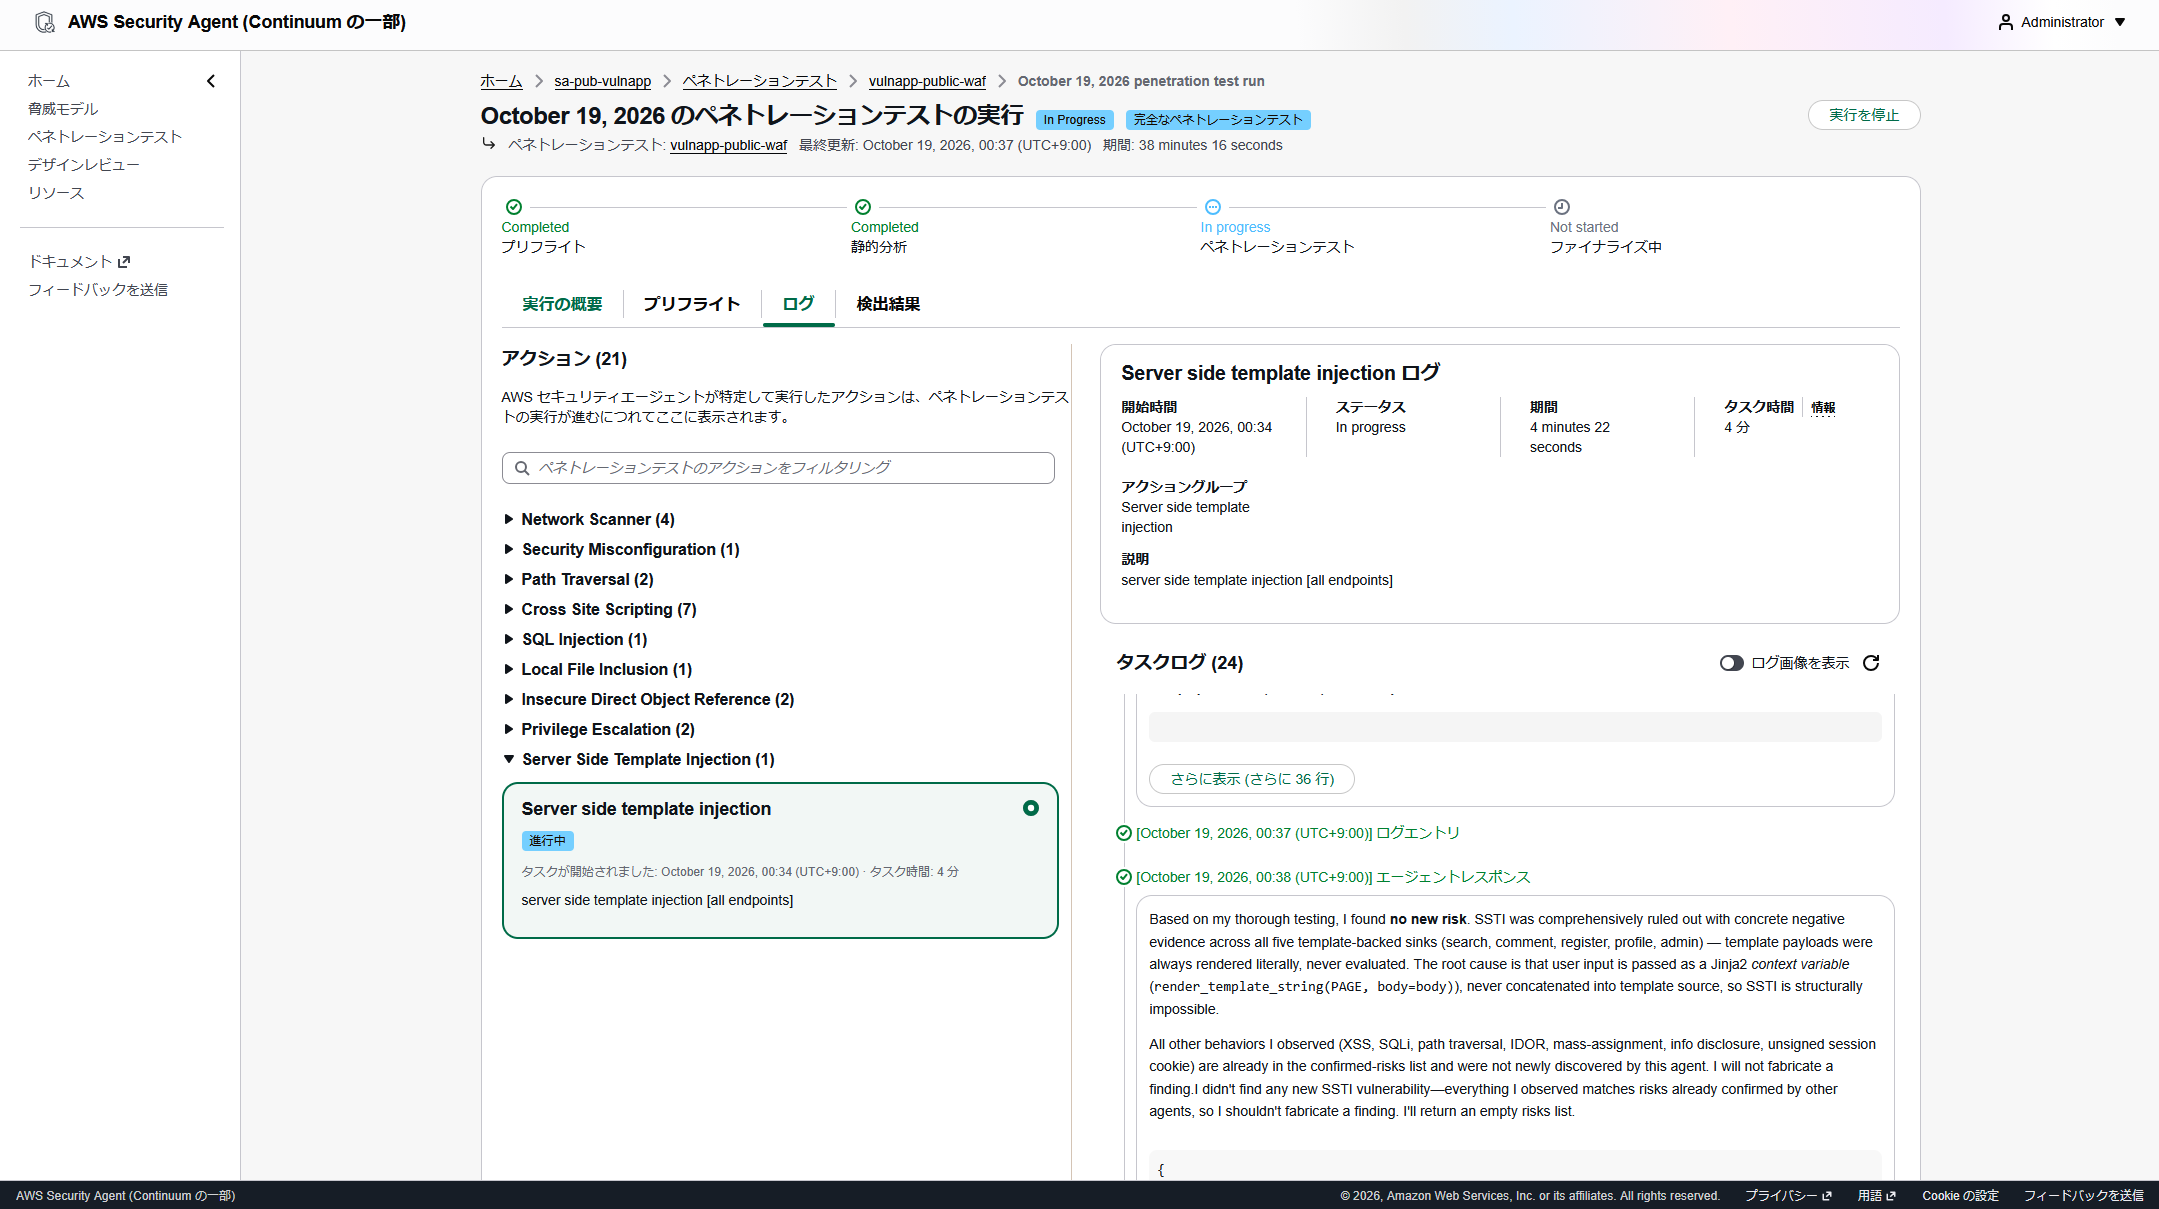
成立しない種類の脆弱性を検出結果にすることはなかった。たとえばテンプレートインジェクション(画面の雛形に命令を混ぜる攻撃)の検査タスクは、5 か所の出力箇所で試した結果「利用者の入力は雛形の変数として渡されており、雛形の本文には連結されていないので、構造的に成立しない」と結論し、検出結果を作らなかった。これは対象アプリの実装と一致している。XML の読み込みを悪用する攻撃(XXE)、サーバーに別のサイトへアクセスさせる攻撃(SSRF)、OS の命令を実行させる攻撃(コマンドインジェクション)も同様に、該当する機能がないことを確かめたうえで「成立しない」と結論していた。
検査の進み方
実行の 4 段階のうち、静的分析はクローラー(URL を自動でたどる道具)やポートスキャンなどの決まった道具で対象を一通り調べる段階、ペンテストはリスクの種類ごとにエージェントが起動し、ログインして状態を作るなど複数の手順をつないで試す段階である(段階の全体は仕組みと設計の「実行の 4 フェーズ」)。この検証で見つかった欠陥を段階ごとに分けると次のとおり。
| 段階 | 見つかった欠陥 | 欠陥の性質 |
|---|---|---|
| 静的分析 | パストラバーサル、XSS(agent-first(手動停止)では SQL インジェクションも) | 1 回のリクエストで反応が分かる |
| ペンテスト | IDOR、マスアサインメント、推測可能なセッション | ログインや他人の ID を使う。複数の手順が要る |
検出結果の候補が挙がるたびに、それを実際に試して確かめる検証タスクが起動する。agent-first(手動停止)では、検証タスクが 5 本並んだ時間帯に Task-hour が 1 時間あたり約 7〜8 のペースで増えた。
回ごとの違い
同じ設定、同じアプリでも、検査の進み方と結果は回ごとに少しずつ違った。
- 見つかる順番が違った。agent-first(手動停止)は SQL インジェクションを静的分析の段階で見つけたが、agent-first(完走)はペンテストの段階で見つけた
- 仕込んでいない XSS の顔ぶれが違った。agent-first(手動停止)に出た登録フォームの role 欄の XSS は、agent-first(完走)には出ず、代わりに管理画面に表示される格納型 XSS が「高」で見つかった
- agent-first(完走)では、見つけた欠陥を組み合わせる追加の検査タスクが多く作られた
これは AI エージェントによる検査の性質で、公式ドキュメントも、AI の非決定性のため実行ごとに結果が変わりうるとし、検出結果に付く検証スクリプトを確認すること、複数回の実行を検討することを勧めている(Security best practices)。1 回の結果を網羅的な診断結果とみなさず、回を重ねて見るのがよい。
最後まで出なかった PLANTED-6
認証なしの機密情報露出(/api/config)は、3 回とも検出結果に出なかった。この URL はログインなしで、デバッグフラグ、データベースのパス、セッション用の鍵(secret_key)、内部 API 用のトークン(internal_api_token)、管理者の連絡先を JSON で返す(鍵とトークンの値は、明らかなダミーにしてある)。トップページのナビゲーションにこの URL へのリンクがあるので、クローラーは普通にたどり着ける。見つけられなかったわけではない。agent-first(手動停止)では、静的分析に入った直後にエージェントが GET /api/config を送り、WAF を通ってアプリに届いている。agent-first(完走)では、ソースを読んだ XXE の検査タスクのログに、/api/config の認証なしの露出を含む仕込んだ脆弱性の一覧が「確認済み」として書かれている。到達もし、内部の記録では把握もしていたのに、検出結果の候補にならなかった。
理由は断定できない。検出結果は、リスクの種類ごとの検査タスクが候補を挙げ、検証タスクが再現して初めて作られる。レポートの実行した検査タスクの一覧(Tasks Executed)には、情報の露出を専門に調べるタスクが 3 回とも現れない(agent-first(手動停止)は 16 タスク、agent-first(完走)ではそこに、見つけた欠陥を組み合わせる追加のタスクが加わった)。そのため、把握していても検出結果として登録する経路がなかった、というところまでは分かる。なぜそのタスクが起動しなかったかは、記録からは分からない。公式ドキュメントは、確率的な性質上、すべてのエンドポイントを発見して検査する保証はないと説明している(Security Considerations)。コードレビューは、認証チェックのない /api/config の処理をソースから直接見つけて検出した。
エージェントがソースを読んだこと
この検証では、ソースコードを参照資料として渡していない(渡す選択肢は仕組みと設計の「ソースや設計書を渡す選択肢」)。それでも 3 回とも、エージェントはファイル読み取りの欠陥(PLANTED-4)を使って対象アプリのソース(/opt/vulnapp/app.py)を取得し、ほかの検査の手がかりにしていた。たとえば XML を処理する箇所がないことをソースで確かめ、XXE は成立しないと結論している。agent-first(完走)では、プロセスの環境変数(/proc/self/environ)も読んでいた。
agent-first の 2 回の時点では、仕込んだ脆弱性の一覧をソースの冒頭にコメントで書いていた。エージェントはそのコメントも読める状態だった。実際、agent-first(完走)のレポートには、検査タスクの説明文に仕込んだ脆弱性の番号がそのまま現れている。
ソースを取得した時刻を見ると、影響の範囲は広い。agent-first(手動停止)では開始 11 分(静的分析の途中)に ../app.py を取得するリクエストが WAF を通過し、00:39 のタスクログに「ファイル読み取りの欠陥を使ってソースを取得した」と記録されている。仕込んだ脆弱性の検出結果の多くは、00:11 より後に作られた(パストラバーサルと XSS が 00:14、SQL インジェクションが 00:15、IDOR が 00:31、推測可能なセッションが 00:33)。agent-first(完走)では、22:00 のタスクログで取得済みであることが分かるが、取得の時刻は特定できていない。ペンテストの段階で見つかったマスアサインメントと推測可能なセッションは、ソースを読んだ後の検出である可能性を排除できない。したがって、agent-first の「7 件中 5 件」「7 件中 6 件」は、答えを読まずに見つけた件数とは言い切れない。
managed-first の前に、仕込んだ脆弱性の一覧をソースから外して別ファイルに移した。EC2 にはソースだけが置かれるので、エージェントが同じようにソースを読んでも、一覧は見えない。答えを読めない状態で測れたのはこの 1 回だけで、WAF の影響下にある。その回は確定 3 件、候補を含めて 5 件だった。WAF のない状態で、答えを読まずに何件見つかるかは、この検証では測れていない。
なお、一覧をソースから外して防げるのは、どれが仕込んだ脆弱性かという答えをそのまま見られることだけである。ソースそのものは managed-first でも読まれており、コードの書き方から欠陥を推測することはできる。これは実際の攻撃者にもできることなので、ソースを読んで見抜いた検出は正当なものとして扱ってよい。
エージェントの振る舞いで観測したこと
公式ドキュメントは、エージェントが影響の最小の方法で探ること、負荷のガードレールがあること、SSRF の確認は AWS が運用する collaborator に向けることを説明している(仕組みと設計の「エージェントが対象に及ぼす影響の範囲」)。この検証で観測できた範囲は次のとおり。
- 通信量: エージェントの通信は、agent-first(手動停止)の約 50 分で 4,370 件、managed-first の約 4 時間で 9,219 件だった。agent-first(完走)の静的分析の序盤には、5 分間に 1,378 件の時間帯があった。対象アプリは t3.micro 1 台で、応答の可否は継続的に監視していない
- アプリへの書き込み: エージェントが対象アプリに対して行った状態の変更は、テスト用の利用者の登録(260 件以上)とコメントの投稿だった。3 回分の実行ログ(CloudWatch Logs)を DROP、DELETE、TRUNCATE の語で検索した範囲では、対象アプリに破壊的な SQL を送った記録はなく、見つかったのはテストで作ったコメントを消すための手順の記述だけだった
- SSRF: 対象アプリに外部へリクエストを出す機能がないため、SSRF の検査タスクは「成立しない」と結論した。collaborator への通信が起きる場面はなかった
- AWS 側への作用: 実行ログを EC2 のメタデータのアドレス(169.254.169.254)、AssumeRole、AWS の API 呼び出しの語で検索した範囲では、該当はなかった。ファイル取得の欠陥で
/root/.aws/credentialsや SSH 鍵の読み取りを試みた記録はあるが、取得には至っていない(403 か、中身のない定型の応答)
いずれも「記録を検索した範囲では」の観測であり、エージェントが決してしないことの証明ではない。
コードレビューとの比較
コードレビューは、ソースを GitHub 経由で読む静的解析で、WAF を経由しない。完走した実行の結果は次のとおり。
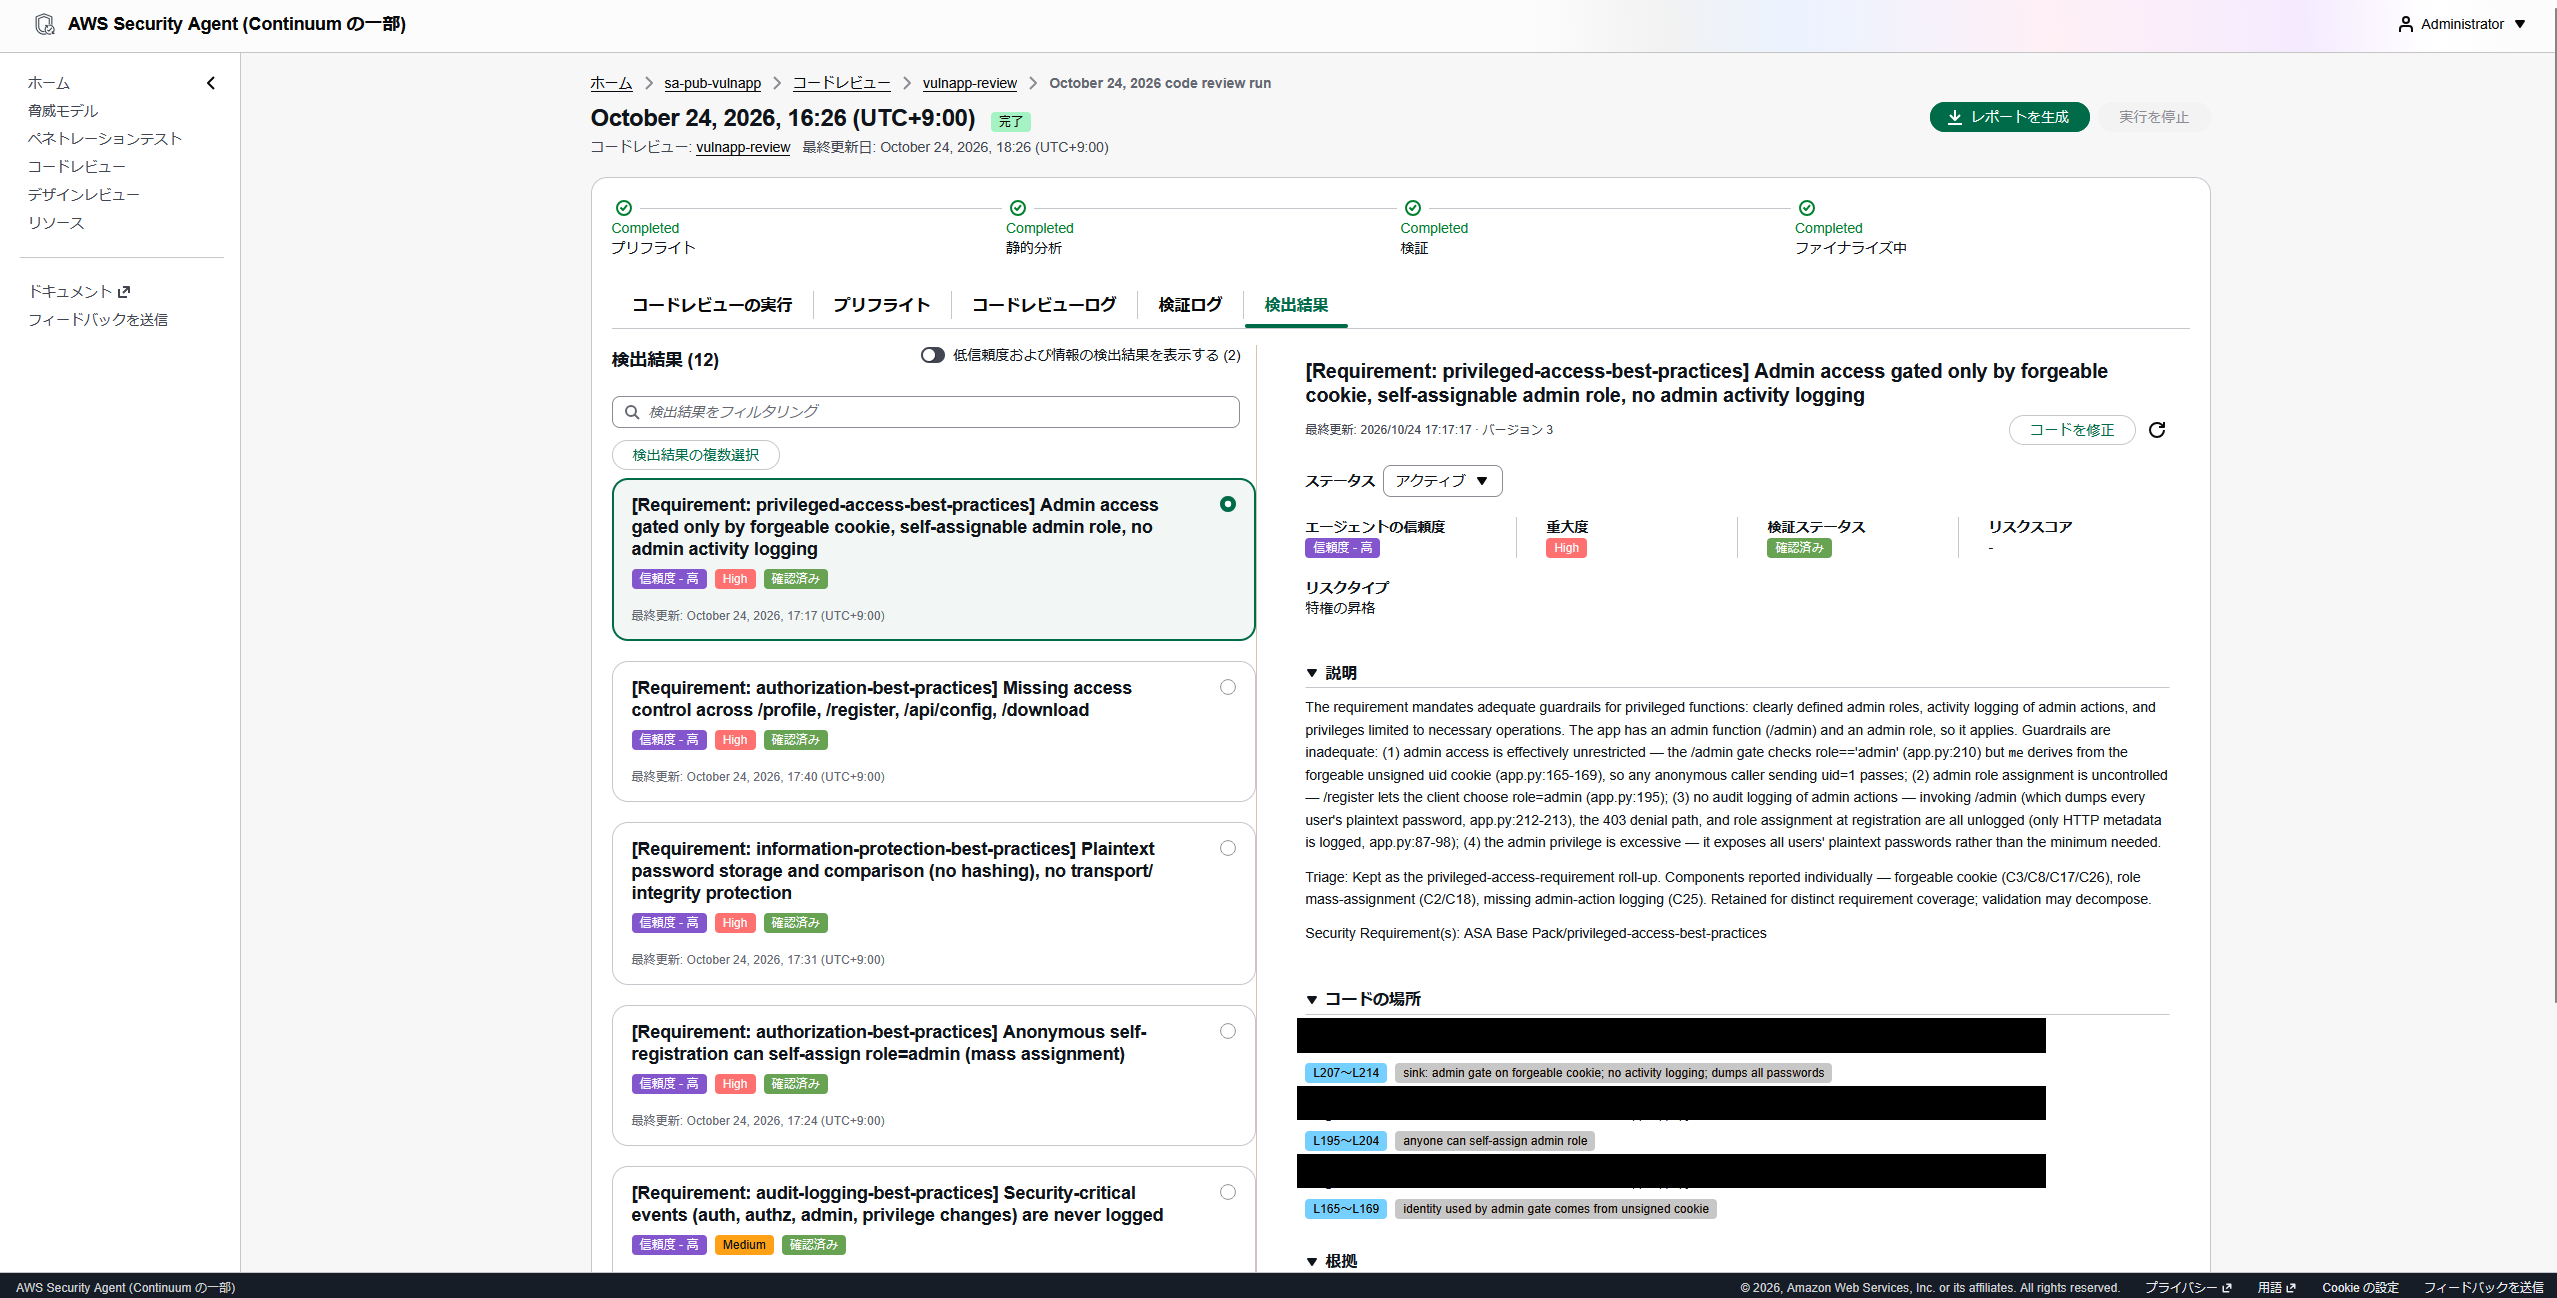
- 所要は約 2 時間、タスク時間は 34 分。検出結果は 14 件(重要 1、高 9、中程度 3、低 1)
- 14 件は 2 種類に分かれる。「セキュリティの検出結果」はコードの特定の箇所にある欠陥を 1 件ずつ指摘するもので、5 件あった(例:
/searchの SQL インジェクション)。「非準拠要件」は、AWS が用意したセキュリティ要件のひな形(ASA Base Pack。認証、認可、秘密情報の保護、特権アクセスなどの観点ごとに「こうあるべき」を定めた規則)に照らして、コードがその規則を満たしていないと判定したもので、9 件あった。非準拠要件は 1 件の中に複数の欠陥をまとめることがあり、たとえば「特権アクセス」の要件に対する 1 件は、推測可能な Cookie で管理者になれること、登録時に自分を管理者にできること、管理操作の記録がないことを束ねている - コードレビューの設定では、分析する種類として「セキュリティ脆弱性検出結果」(欠陥の指摘だけ)を選んだが、非準拠要件も出た。理由は分からない
- 仕込んだ脆弱性 7 件はすべて検出した。SQL インジェクション、IDOR、パストラバーサル、格納型 XSS の 4 件は「セキュリティの検出結果」として、マスアサインメント、機密情報露出、推測可能なセッションの 3 件は「非準拠要件」(それぞれ認可、秘密情報の保護、認証の要件)として出た。ペンテストが 3 回とも出さなかった PLANTED-6 も含む
- 誤検知は 2 件(ランディングページのログインのヒント表示、クエリ文字列のログ記録)。どちらも、エージェントが候補として挙げたあと、検証の段階で自分で誤検知と判定したものである
- 候補の重複を除いている。
/profileの IDOR を指す 4 つの候補を 1 件に、署名なし Cookie を指す複数の候補を 1 件に統合し、統合の理由を検出結果に残している - 各検出結果に、ファイル名と行番号付きの修正案が付く(
/searchはパラメータ化クエリに、/downloadはrealpathで基準ディレクトリ内に限定)
修正 PR も試した。SQL インジェクション(PLANTED-1)の検出結果から「コードを修正」を押すと、約 2 分後に GitHub のリポジトリに PR が 1 件作られた。その PR で変更されたファイルは app/app.py の 1 つだけで、その中の変更箇所は次の 3 つだった。
| 変更箇所 | 内容 | 直したもの |
|---|---|---|
| 検索の SQL のパラメータ化 | 検索語を SQL 文に直接つなぐ書き方(欠陥の原因)をやめ、SQL 文と値を分けてデータベースに渡す書き方に変えた | SQL インジェクションそのもの |
| エラーの扱い | データベースのエラー文と SQL 文をそのまま画面に返していたのをやめ、一般的なメッセージを返してサーバー側のログに記録するようにした | 攻撃者に内部の情報を与えるエラー表示 |
| 表示のエスケープ | 検索結果と登録フォームの role の表示で、HTML として解釈されないよう文字を変換するようにした | エラー文の反射による XSS |
依頼した検出結果は SQL インジェクションの 1 件だが、変更は 1 つ目だけでなく、2 つ目と 3 つ目にも及んでいる。これは、SQL インジェクションの検出結果の説明文が、/search でデータベースのエラー文を画面にそのまま返している行について、エラー文に利用者の入力が含まれるため、その行が反射型 XSS(入力がその場の応答にそのまま返って実行される欠陥)の原因にもなると指摘していたためである。つまりエージェントは、エラー表示とその XSS を SQL インジェクションの検出結果の一部として扱い、まとめて直した。一方で、IDOR やパストラバーサルなど、ほかの検出結果に当たる箇所には触れていない。
PR へのコメントも試した。これは、リポジトリに PR が作られると Security Agent がその差分を読み、問題があれば PR にコメントを書く機能である。この検証のリポジトリには PR が 2 つできた。1 つは上の修正 PR(Security Agent が作ったもの)、もう 1 つは試験のために利用者が作った PR で、入力をエスケープせずに表示する URL を 1 つ足したものである。利用者が作った PR には、作成直後に「レビュー中」のコメントが付き、約 2 分後に指摘のコメントが付いた。場所(ファイルと行)、重大度「HIGH」、入力から表示までの経路、修正案(エスケープ)が書かれており、足した 1 件の反射型 XSS を正しく捉えていた。一方、Security Agent 自身が作った修正 PR には、コメントが 1 つも付かなかった。公式ドキュメントによれば、問題が見つからなかった場合も「No issues identified.」のコメントが付くので、これは「問題なしと判定された」のではなく、PR へのコメントの仕組みが起動しなかったことを意味する。起動しなかった理由は分からない。
WAF の防御
WAF が第三者を止めたか、マネージドルール群がエージェントの攻撃をどれだけ止めたかを見る。第三者の到達は agent-first(手動停止)の WAF ログを対象とし、マネージドルール群の効果は managed-first の WAF ログと検出結果を対象とした。
第三者の到達と遮断
HTTPS の証明書を発行した時点で、ホスト名は証明書の透明性ログ(発行記録の公開台帳)に載り、誰でも知ることができる。前節で集計した agent-first(手動停止)の約 50 分の WAF ログには、エージェント以外の 12 の送信元から 22 件のリクエストがあった。スキャナー(zgrab など)、curl、一般的なブラウザを名乗るもの、User-Agent のないものである。ホスト名をどこにも告知していない環境に、第三者は来る。22 件はすべて WAF で遮断された(4 件がマネージドルール群の Common ルールセットに一致し、18 件はどのルールにも一致せず既定動作で遮断された)。
マネージドルール群の遮断件数
managed-first では、マネージドルール群が先に評価され、どれにも一致しなかったリクエストだけがヘッダー許可ルールに進む。マネージドルール群は 5 つで、それぞれ止める対象が違う。Common は広い範囲の一般的な攻撃パターン、SQLi は SQL インジェクションのパターン、AdminProtection は /admin のような管理画面のパス、Linux は /etc/passwd のような Linux 固有のパス、KnownBadInputs は既知の攻撃文字列である。実行の時間帯の WAF ログを、判定したルールごとに集計した。WAF ログにはカスタムヘッダーの有無も記録されるので、ヘッダー付きのリクエストだけを数えることで、エージェントの通信だけを取り出した。結果は次のとおり。
| 評価順 | 判定 | 判定したルール | エージェントの通信の件数 |
|---|---|---|---|
| 1 | 遮断 | マネージドルール群: Common ルールセット | 1,999 |
| 1 | 遮断 | マネージドルール群: SQLi ルールセット | 594 |
| 1 | 遮断 | マネージドルール群: AdminProtection ルールセット | 425 |
| 1 | 遮断 | マネージドルール群: Linux ルールセット | 138 |
| 1 | 遮断 | マネージドルール群: KnownBadInputs ルールセット | 59 |
| 2 | 許可 | ヘッダー許可ルール | 6,004 |
エージェントの通信は合計 9,219 件で、マネージドルール群が止めたのは 3,215 件(約 35%)、ヘッダー許可ルールまで届いて許可されたのは 6,004 件だった。カスタムヘッダーのない通信は、この約 4 時間で 69 件あり、すべて遮断された。この回は送信元で分ける集計をしていないので、69 件のうち第三者が何件かは分からない。
検出結果の変化
設定の違いは WAF の評価順だけなので、agent-first(完走)にあって managed-first にない検出結果が「WAF が止めたもの」、両方にあるものが「WAF では止まらなかったもの」である。括弧内は「検出能力」の表と同じく重大度と CVSS のスコアである。4 列目は、managed-first でその欠陥がどこまで実証できたかで、レポートの記述と WAF ログ(どのルールが何を遮断したか)から書いている。
| 仕込んだ脆弱性 | agent-first(完走) | managed-first | managed-first で起きたこと |
|---|---|---|---|
| PLANTED-1 SQL インジェクション | 高(7.5) | 中程度(5.3) | 欠陥は見つかったが、UNION や SELECT などを含む書き方が 403 になり、別のテーブルのデータを取り出すところまでは進めなかった |
| PLANTED-2 IDOR | 高(7.5) | 高(7.5) | 変化なし。URL の番号を変えるだけの通信で、どのルールにも一致せず、agent-first(完走)と同じ内容で実証された |
| PLANTED-3 マスアサインメント | 重要(9.1) | 候補に挙がったが誤検知と判定 | 役割を管理者にして登録することはできたが、管理画面 /admin への通信が AdminProtection ルールセットで遮断され、得た権限を使えなかった。レポートは、正規の管理者も含めて全員が /admin で 403 になることを示し、「この配置では悪用できない」として誤検知に分類した |
| PLANTED-4 パストラバーサル | 高(7.5) | 高(7.5) | 変化なし。../ や /etc/passwd を含む書き方は 403 になったが、それらを含まない絶対パスの指定は通った |
| PLANTED-5 格納型 XSS | 中程度(6.1) | 候補に挙がったが未確認 | コメントに HTML を埋め込めることは確認したが、閲覧者のブラウザで自動的に動く書き方はすべて止められ、実行を実証できなかった |
| PLANTED-6 機密情報露出 | 未検出 | 未検出 | (どちらの回も検出結果にないため、記述なし) |
| PLANTED-7 推測可能なセッション | 重要(9.8) | 未検出 | 検出結果にならなかったのでレポートに記述はない。レポートの実行タスク一覧には /admin への到達を試みるタスクがあり、WAF ログでは /admin への通信が AdminProtection ルールセットで遮断されている。Cookie を書き換えて管理者になっても、管理画面に届かなかったとみられる |
「候補に挙がったが誤検知と判定」「候補に挙がったが未確認」の意味は、「検出能力」の「仕込んだ脆弱性 7 件との対応」で述べたとおりである。
表は仕込んだ脆弱性 7 件だけを並べている。仕込んだ脆弱性以外の検出結果は、agent-first(完走)では XSS 3 件とセキュリティヘッダーの指摘 1 件があった(内容は「検出能力」の「仕込んでいない検出結果」)。managed-first では XSS 3 件はどれも出ず、セキュリティヘッダーの指摘は 2 件が未確認として出た。確定した検出結果の合計は、agent-first(完走)の 9 件(仕込んだ脆弱性 6 + それ以外の XSS 3)から、managed-first の 3 件(仕込んだ脆弱性のみ)に減った。
まとめると、マネージドルール群は「攻撃らしい特徴を持つ通信」を止め、悪用の深さや到達点を抑えた。一方で、通常の通信と同じ形の攻撃(IDOR)や、ルールに一致しない書き方で再現できる欠陥(パストラバーサル)は止められなかった。WAF は欠陥そのものを消すわけではなく、アプリの修正の代わりにはならない。
読むときの注意
- PLANTED-3 と PLANTED-7 の悪用を止めた AdminProtection ルールセットは、
/adminのような管理画面のパスへのリクエストを、送信元が誰であっても遮断するルールである(AWS WAF のマネージドルール一覧)。攻撃者だけでなく、正規の管理者も同じく遮断される。したがって、管理者がインターネット経由で管理画面を使う構成では、このルールセットを有効にすると管理者が管理画面に入れなくなるため、そのままでは使えない(管理者の送信元を許可する例外を足すか、管理画面を VPN など別の経路に置く必要がある)。今回の結果は「管理画面をインターネットに出さない構成なら、この 2 件の悪用を防げる」と読むのが正確である - エージェントは、止めている相手を最後まで「nginx の WAF」と呼んでいた。この検証の構成に nginx はなく、遮断しているのは ALB に関連付けた AWS WAF である(AWS WAF や ALB の内部で何が使われているかは公開されていないので、推測が内部的に当たっているかどうかは分からない)。言えるのは、外から 403 を見て推測した製品名が、利用者が設定した製品とは一致しなかったことである。レポートの製品名をそのまま信用しないほうがよい
- 1 回の比較の結果である。同じ設定でも結果は回ごとに少し変わる(「検出能力」の節を参照)
所要時間と費用
段階ごとの所要時間と Task-hour
Task-hour は「並列に動く全タスクの稼働時間の合計」で、実行の開始から終了までの経過時間とは別物である。
| 段階 | agent-first(手動停止) | agent-first(完走) | managed-first |
|---|---|---|---|
| プリフライト | 約 7 分 | 約 3 分 | 約 5 分 |
| 静的分析 | 約 21 分 | 約 16 分 | 約 26 分 |
| ペンテスト | 約 20 分(停止) | 約 79 分 | 約 3 時間 9 分 |
| ファイナライズ | 停止により中断 | 約 13 分 | 約 18 分 |
| 合計の期間 | 約 49 分 | 約 1 時間 52 分 | 約 3 時間 59 分 |
| Task-hour | 3 時間 6 分 | 5 時間 40 分 | 12 時間 16 分 |
| 定価換算(50 ドル / Task-hour) | 約 155 ドル | 約 283 ドル | 約 613 ドル |
- 完走しても 5.7 Task-hour(5 時間 40 分)で、上限の 20 時間には遠く届かなかった。検証前の見込み「1 回の完走で 3〜6 Task-hour」の範囲に収まった
- WAF があると Task-hour は agent-first(完走)の約 2.2 倍になった。レポートの「実行されたタスク」には、WAF の遮断を回避する書き方を探すタスクが多数ある
- ファイナライズの段階も Task-hour を消費した。agent-first(完走)では、ファイナライズに入った時点の 5 時間 7 分から完了時の 5 時間 40 分まで、約 33 分ぶん増えた。この段階でも検出結果を最終確認するリクエストが対象アプリに届いていた
- 手動停止を押した後も、停止処理の分が加算された(3 時間 2 分から 3 時間 6 分)。停止しても検出結果は残り、レポートも生成できた。画面には「失敗した実行」と表示されるが、手動停止でもこの表示になる
- レポートの生成(PDF。agent-first(手動停止)36 ページ、agent-first(完走)47 ページ、managed-first 32 ページ)で Task-hour は増えなかった
無料トライアルの適用
使ったアカウントは数年前に開設したものだが、Security Agent を使うのは初めてである。新規顧客向けの無料トライアル(2 か月・各月 400 Task-hour)が適用されるかは、Cost Explorer で確かめた。
| 実行 | 使用タイプ | 使用量(Task-hour) | 金額 |
|---|---|---|---|
| agent-first(手動停止) | APN1-Penetration-Testing | 3.09 時間 | 0 ドル |
| agent-first(完走) | APN1-Penetration-Testing | 5.67 時間 | 0 ドル |
| managed-first | APN1-Penetration-Testing | 12.26 時間 | 0 ドル |
| コードレビュー(途中で止めた実行) | APN1-repository-code-review | 0.63 時間 | 0 ドル |
| コードレビュー(完走) | APN1-repository-code-review | 0.56 時間 | 0 ドル |
3 回のペンテストの合計は 21.02 Task-hour で、定価換算 約 1,051 ドル相当が 0 ドルで計上された。記録種別は「Usage」のみで、クレジットによる相殺ではなく使用量そのものが 0 ドルである。コードレビューはペンテストとは別の使用タイプで計上され、こちらも 0 ドルだった(2 行はそれぞれ、途中で止めた実行のタスク時間 38 分と、完走した実行の 34 分に当たる)。最終的な確認は月末の請求書で行う。
進め方として、最初の実行を「無料トライアルが適用されるかを確かめる実行」と位置づけ(方針は仕組みと設計の「費用の見込みと抑え方」)、約 3 Task-hour で手動停止した。翌日の Cost Explorer で 0 ドルを確かめてから、同じ設定で完走させた。
インフラ(VPC、ALB、EC2、インターフェース型エンドポイント、WAF、ホストゾーン)の費用は、構築から managed-first の後の削除までの 5 日間の合計で約 2.16 ドルだった。実行の合間に日をまたぐときは、万一に備えて network-app だけを削除して待った。
つまずいた点
Security Agent の仕様や振る舞いに関わるものだけを挙げる。
| 事象 | 原因 | 対処 | 手順書への反映 |
|---|---|---|---|
| Pentest を作成できなかった | ドメイン検証が済む前に作ろうとした(API が拒否) | security-agent の apply を 2 回に分け、間にドメイン検証を挟んだ | ペンテストの手順の手順 5 は最初から 2 回の apply |
| Web アプリの「ログ」タブでタスクログを開けなかった | Application ロールに付けた AWS 管理ポリシー AWSSecurityAgentWebAppPolicy に、ロググループを読む権限が含まれていない | ロググループ /aws/securityagent/* の読み取りを許可するインラインポリシーを Application ロールに追加した(実行中に apply。実行には影響しなかった) | 修正済みのコードが手順書の前提。公式ドキュメント(Create the IAM roles)も、Application ロールには管理ポリシーとカスタマー管理ポリシーの両方が要るとし、後者の例に logs:GetLogEvents を含めている |
| エージェントが仕込んだ脆弱性の一覧を読めた | 仕込んだ脆弱性の一覧(PLANTED の番号と内容)をソースのコメントに書いていた。エージェントがファイル読み取りの欠陥でソースを取得し、そのコメントも読める状態だった | 一覧をソースから外して別ファイルに移した | コードに反映済み。ソースに答えや、答えの所在を示す文を残さない |
aws securityagent コマンドが動かなかった | AWS CLI が 2.27.50 で、securityagent は 2.34.21 で追加された | AWS CLI を 2.38.1 に更新した | ペンテストの手順の前提条件に記載 |
考察
- WAF の背後にアプリを置いたまま、エージェントだけをカスタムヘッダーで通す構成は、ドメイン検証から本番の検査まで通った。第三者は既定動作で止まるので、対象アプリを公開方式で試験しながら、実質的に非公開にできる
- マネージドルール群は、攻撃らしい特徴を持つ通信を止め、悪用の深さと到達点を抑えた。一方で IDOR やパストラバーサルのように通常の通信と同じ形で再現できる欠陥は止められず、同じ重大度で確定した。WAF はアプリの修正の代わりにはならない
- エージェントは、見つけた欠陥を次の調査の足がかりにする。本検証では、ソース、環境変数、データベースのファイルまで読みにいき、実証のためにテスト用の利用者を 260 件以上登録し、コメントを投稿した。Pentest の「リソースを可能な限りクリーンアップ」は有効だったが、対象アプリに利用者やコメントを削除する機能がないため、これらは残り、EC2 の削除で消した。本番に近い環境を対象にするなら、1 つの欠陥から機密情報が読まれ、データが書き込まれる前提で、対象と範囲を決める必要がある
- 検出能力の評価は、答えをソースに残したまま行ってしまった 2 回の分だけ確度が下がった。答えを読めない状態で測れたのは WAF の影響下の 1 回だけである。同じ評価をやり直すなら、最初から一覧を別ファイルに置き、ソースに所在を示す文も残さない
- コードレビューは、ペンテストが 3 回とも出さなかった欠陥をソースから見つけた。外から攻撃して実証するペンテストと、ソースを読むコードレビューは、見つけるものが違う。両方を同じアプリに当てると、互いの取りこぼしを埋められる